Matthias Crasselt
Product LeadAI · Cloud · CRM · Data
Über mich
Seit über fünfzehn Jahren arbeite ich an digitalen Produkten, heute als Product Lead in einem Medienhaus. Dazu gehört die Weiterentwicklung von Redaktionssystemen, Webanwendungen und Cloud-Infrastruktur ebenso wie der Weg von Rohdaten zu Reports und Dashboards, auf deren Basis Entscheidungen getroffen werden. Davor war ich im digitalen Marketing und in einer Digitalagentur für Verbände und Auftraggeber aus dem öffentlichen Sektor tätig.
Zwischen Roadmap und Terraform-Code fühle ich mich gleichermaßen wohl: Am meisten Spaß macht mir der Moment, in dem aus einer Idee etwas wird, das man tatsächlich betreiben kann. Aktuell fasziniert mich, wie KI die Entstehung von Software verändert — die Projekte unten sind beim Vibe Coding entstanden, also im Dialog mit KI-Assistenten vom ersten Prompt bis zum Deployment.
Zertifikate
Eigene Projekte
-
feuerstellenkarte.de
Eine Karte der öffentlich zugänglichen Grillplätze und Feuerstellen in allen sechzehn Bundesländern, über zehntausend an der Zahl. Die Plätze stammen ausschließlich aus OpenStreetMap und werden wöchentlich neu geholt; Grillplätze, Feuerstellen, Picknick- und Campingplätze sind getrennt kategorisiert und lassen sich nach Ausstattung und Umgebung filtern.
Da neun von zehn Plätzen in OpenStreetMap keinen Namen tragen, sucht der Datenbau deshalb den nächsten Ort oder das nächste Gewässer und macht aus einem namenlosen Punkt eine „Feuerstelle bei Rheinsberg" oder eine „am Hellsee". Dazu kommen die Suche nach Postleitzahl, eine eigene Seite je Platz und je Bundesland eine Seite zur Rechtslage.
Jeder Platz zeigt die Waldbrandgefahr aus dem Index des DWD, mit Messstation und Entfernung. Technisch eine statische Seite ohne Framework und ohne Datenbank: Leaflet liegt lokal, die Daten baut eine Node-Pipeline aus den Geofabrik-Auszügen, und GitHub Actions hält alle Daten ohne Zutun aktuell.
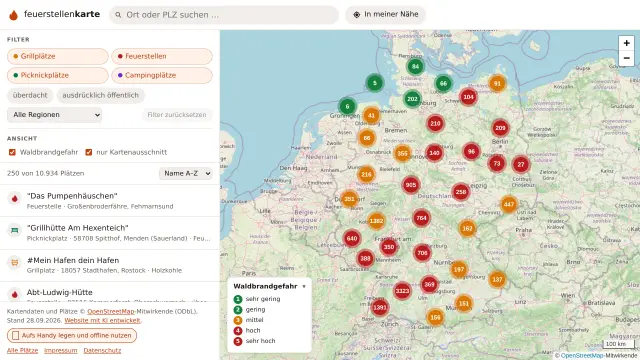
Startansicht mit Filtern, Platzliste und Waldbrandgefahr je Region. Kartendaten © OpenStreetMap-Mitwirkende. 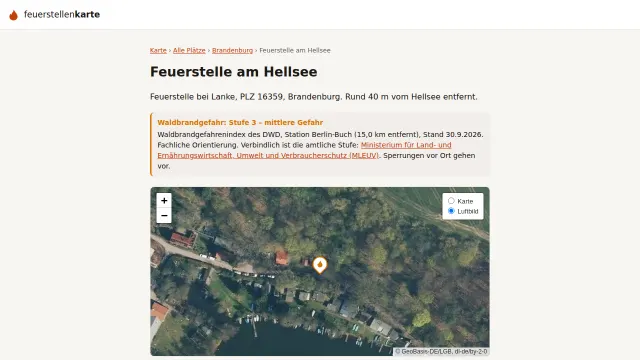
Platzseite der Feuerstelle am Hellsee: Lage, Waldbrandgefahr mit Messstation und Luftbild. Luftbild © GeoBasis-DE/LGB, dl-de/by-2-0. -
tagespegel.de
Ein Promillerechner, der aus Getränken und Körperdaten den Blutalkoholpegel schätzt: aktueller Wert auf einer „Pegellatte", Spitzenwert mit Uhrzeit, Kater-Prognose, Promille-Verlauf und der Zeitpunkt, ab dem man rechnerisch wieder bei 0,0 ‰ ist.
Gerechnet wird nach Widmark, auf Wunsch mit den Verteilungsfaktoren nach Seidl oder Watson, sobald Größe und Alter vorliegen. Eine Minute-für-Minute-Simulation bildet Aufnahme und Abbau ab; das Band um die Kurve spannt langsamen gegen schnellen Stoffwechsel und ist ausdrücklich als grobe Bandbreite ausgewiesen, nicht als statistischer Vertrauensbereich.
Die gesamte Berechnung läuft im Browser — kein Server sieht die Eingaben, es gibt kein Tracking und keine Requests an Dritte. Gespeichert wird nur nach ausdrücklicher Einwilligung und nur lokal beim Nutzer; ist sie aus, liegt kein einziger Schlüssel im Speicher des Browsers. Umgesetzt in reinem Vanilla-JavaScript, als installierbare App (PWA) in fünf Sprachen, samt handgeschriebenem SVG-Diagramm.

Beispielrechnung: zwei große Bier und ein Wein zwischen 20:30 und 22:00 Uhr, Stand 22:30 Uhr. 
Dieselbe Beispielrechnung im Verlauf, mit Schwankungsbreite und den Grenzen für Fahrverbot und Straftat.